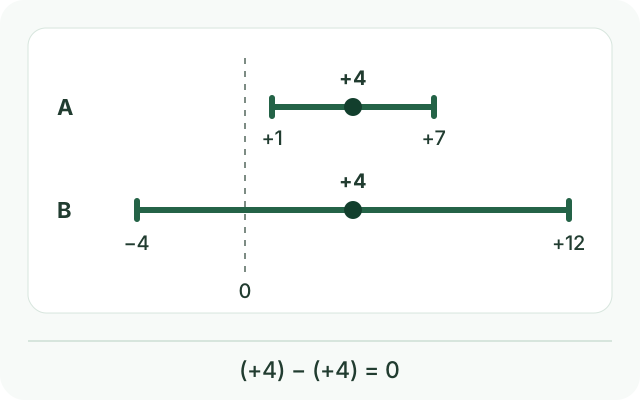
Intervalles à 95% inventés, aucun résultat réel d’arrêt. Tous les nombres sont des points de pourcentage. Zéro est la référence au sein de chaque sous-groupe, pas un test déjà effectué de A contre B.
- A et B : +4
Les points sont identiques malgré les étiquettes différentes.
- (+4)−(+4)=0
Différence des points, pas preuve d’égalité ni remplacement de son intervalle.
Derrière le titre, deux points identiques
Ce rapport est entièrement fictif : aucun essai, produit ou effet réel. Des adultes sont répartis au hasard entre consultations habituelles seules et consultations plus une réunion collective. A et B désignent des horaires de travail fixes ou variables notés avant la répartition, pas l’aide utilisée ensuite. Le critère défini à six mois est le même.
La différence absolue fictive est de +4 points de pourcentage dans les deux sous-groupes. Les intervalles illustratifs à 95% vont de +1 à +7 dans A, de −4 à +12 dans B ; le rapport qualifie seulement A de significatif. Ces résumés inventés ne sont pas calculés à partir d’effectifs. Ni valeurs p réelles ni résultat d’interaction ne sont fournis.
Les points donnent (+4)−(+4)=0 point. Cela ne prouve pas l’égalité des effets sous-jacents : l’incertitude de leur différence manque. ‘Seul A en bénéficie’ ajoute toutefois une distinction non démontrée par les étiquettes. On peut noter : ‘Estimations égales, B moins précis ; comparaison directe et intervalle manquants’.
Trouver l’analyse qui teste réellement le titre
Cherchez interaction, modification de l’effet ou test de différences entre sous-groupes. Gardez intervention, comparateur, critère, date d’évaluation et échelle ensemble. Différence absolue et rapport peuvent donner des motifs différents ; ne changez pas d’échelle pour retenir la ligne la plus frappante.
Lisez l’estimation d’interaction et son intervalle, si disponibles, pas seulement la valeur p. Ne pas détecter de différence ne prouve pas l’égalité. Une petite valeur p n’établit pas à elle seule taille, importance pratique ou crédibilité. Sans comparaison directe, la question reste ouverte.
Le chevauchement des intervalles ne remplace pas le test direct. Un petit chevauchement peut accompagner une différence statistiquement détectable. Les deux étiquettes comparent chaque sous-groupe à sa propre valeur nulle, pas les sous-groupes entre eux.
Le découpage était-il décidé avant les résultats ?
Ouvrez le protocole ou plan d’analyse daté : facteur, catégories ou modèle continu, direction attendue et justification. CONSORT demande de distinguer analyses supplémentaires prévues et post hoc, et d’en rapporter les résultats. ‘Prévu’ ne signifie pas confirmé.
Examinez toute la recherche de motifs : facteurs, seuils, critères, temps, modèles et prise en compte de la multiplicité. Choisir le découpage le plus favorable après lecture des résultats diffère du test de quelques hypothèses justifiées. Même planifiées, les analyses doivent être confrontées à l’incertitude, aux données antérieures et à la réplication indépendante.
Sous-groupes d’un essai ou groupes d’essais différents ?
Pour une caractéristique mesurée avant la répartition, un essai peut comparer les interventions randomisées au sein des sous-groupes initiaux. La caractéristique elle-même n’est pas randomisée ; méthodes adaptées, données suffisantes et examen des biais restent nécessaires. Découper selon présence ou réponse après répartition est une autre comparaison, potentiellement sélectionnée.
Une revue comparant des essais entiers avec surtout des horaires fixes à d’autres essais aux horaires variables change aussi les études comparées. Pays, accompagnement de base ou autres caractéristiques peuvent varier. La randomisation de chaque essai ne permet pas d’attribuer simplement cette association entre essais aux horaires.
Pas de barrière individuelle fondée sur l’étiquette
Vos horaires, votre histoire tabagique et vos données de santé sont inutiles ici. Les moyennes ne décident pas si vous devez être accompagné. Tabac info service propose un annuaire de tabacologues et mentionne le médecin traitant ; vérifiez les conditions locales. Les options personnelles se discutent avec un professionnel qualifié, pas avec une étiquette de sous-groupe en ligne.
À retenir
Sources
Les affirmations centrales de cette page ont été vérifiées à partir des sources suivantes.
- Cochrane: Cochrane Handbook chapter 10 — subgroup differences, interaction and within/between-study distinctions
Sources vérifiées: 2026-10-04
- SPIRIT–CONSORT Group: CONSORT 2025 expanded checklist — items 3, 21d and 28
Sources vérifiées: 2026-10-04
- ICEMAN authors: ICEMAN author manual for randomized controlled trials — prior hypotheses, interaction, multiplicity and cut points
Sources vérifiées: 2026-10-04
- ICEMAN authors: ICEMAN preliminary considerations — outcome, time point, effect scale and baseline modifiers
Sources vérifiées: 2026-10-04
- ICEMAN authors: ICEMAN author manual for meta-analyses — within-trial and between-trial comparisons
Sources vérifiées: 2026-10-04
- Santé publique France / Tabac info service: Trouver un tabacologue
Sources vérifiées: 2026-10-04
Lecture de recherche publique. Exemple et graphique entièrement fictifs ; aucune prévision personnelle, aucun diagnostic, choix de traitement ou recueil de données.